引言
国际惯例先上代码
https://github.com/other3000/AbundantVoxel
github.com/other3000/AbundantVoxel
如标题所示,本系列文章将简单阐述一种大规模(2^3^16)runtime可编辑体素的尝试,体素值为MaterialID(uint32),限于篇幅原因本文重点先放在数据结构方向且目前只在CPU上,渲染方案目前还在搞,具体思想参考论文
https://graphics.tudelft.nl/Publications-new/2020/CBE20/ModifyingCompressedVoxels-main.pdf
graphics.tudelft.nl/Publications-new/2020/CBE20/ModifyingCompressedVoxels-main.pdf
该插件是基于该论文并稍微修改部分实现后在UE中的简单尝试,仅作为思考笔记记录下来,后续该文章也有可能会改不少,如有纰漏还请各位大佬指正,有相关想法的也欢迎评论交流
数据结构
其算法思路相较传统的八叉树划分,该数据结构将Location转换为了index,然后相同的节点统统合并,这样就变成了整张DAG图存储的其实是所有变化的区域怎么变化的,从而实现了更大程度的压缩,但是弊端在于每次查找必须细分到底
Node
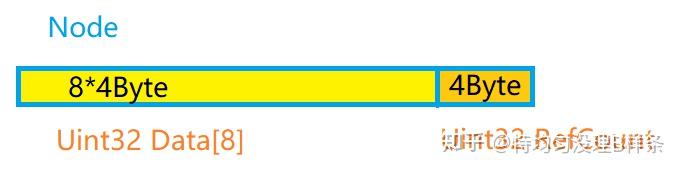
DAG中的节点有两种类型,一种为InternalNode,一种为DataNode,两种节点大小与组织方式相同,数据编码方式如上图所示,两者的区别在于InternalNode只存储下一个节点索引,而DataNode存储的是对应的那个体素实际的数据,所以目前每个体素存储的数据都是一个uint32,这个uint32可以是很多东西,比如当前是几号材质,或者单纯的一个指针
所有节点大小均为9*4Byte,前8个uint32就是上述的数据,最后一个uint32用于存储引用计数,表示这个节点被引用了多少次,注意这个引用计数存储的不是在上一层有多少个指针指向了该节点,而是算上了上面所有层的一路乘下来的引用计数,这么说可能有点抽象所以我举个例子:
假设我让一个8x8x8的区域内体素值都为114,那么我们就可以得到一个层级关系如下:
NodePool[0] = InternalNode={Data[8]={1,1,1,1,1,1,1,1},Refcount=1};
NodePool[1] = InternalNode={Data[8]={2,2,2,2,2,2,2,2},Refcount=8};
NodePool[2] = DataNode={Data[8]={114,114,114,114,114,114,114,114},Refcount=64};
所以如果我们想要获得有多少个存储数据为114的体素,那么就只需要找到所有包含114的DataNode,然后把所有找到的DataNode里114体素的数量*Refcount全都加起来,就可以获得一共有多少了114号体素了,比如上面的示例,包含114的DataNode就一种,这一种DataNode里包含了8个114号体素了,所以一共有8x64=512个114号体素.
class DAG
TArray<Node> NodePool:没什么可说的,就是一个超大的数组,初始化DAG的时候直接给它分配0xFFFFF个元素,避免内存碎片TQueue<uint32> FreeIndex:用来放引用计数归零的索引,提高内存复用TMap<uint32[8], NodeIndex> InternalMap:同下TMap<uint32[8], NodeIndex> DataMap:用来查询节点的索引,也方便后续快速插入,hashFunction参考https://github.com/aappleby/smhasher/wiki/MurmurHash3- uint8 MaxDepth:最大深度,决定了从根节点往下查询多少次达到数据节点,也决定了体素索引的最大值,计算方法为 $2^{MaxDepth+1}-1$ ,比如最大深度为15,则体素索引的最大值为65535
体素的增删改查
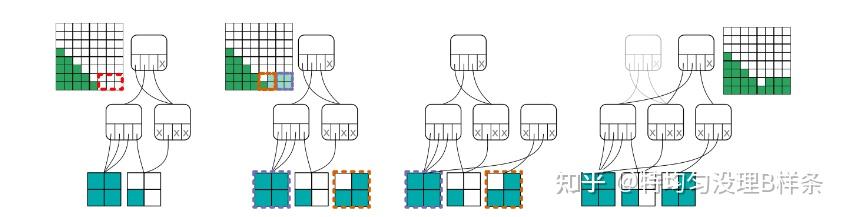 思路流程图,图片来自论文
具体步骤有一点绕,我还是比较推荐看源码或者看上面的图,在这里只描述部分操作细节以及为什么这么做
1.向下查找时如何根据输入向量获得对应子树
#define GET_BIT(x,y) ((x)>>(y)&1)
FORCEINLINE uint8 GetChildIndex(const FIntVector& vector, uint32 level)
{
	uint8 tempx = GET_BIT(vector.X, level);
	uint8 tempy = GET_BIT(vector.Y, level) << 1;
	uint8 tempz = GET_BIT(vector.Z, level) << 2;
	return tempx | tempy | tempz;
}
规则的数据结构优美之处,可以通过位运算快速拿到,具体操作也比较简单,直接获得对应位然后XYZ做个偏移就解决了
2.插入的时候快速判断当前这个节点有没有
所以我们用了一个Map存储,Key为节点,Value为这个节点的索引,如果插入的时候检查hash有的话则直接返回这个节点的索引,并且该节点引用计数+1,节约了大量遍历的时间
3.什么时候该把这个节点从池子里扔掉呢
类似上图中的最后一步,最上面左边的根节点经过修改后重新插入了一个新的节点,旧节点的引用计数-1,当为0的时候自然就可以放进回收队列里并在map中清除它,从而实现了内存复用
一些应用测试
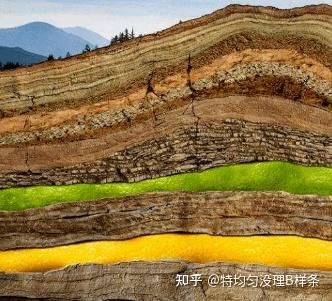
目前是模拟了地质分层,如上图,假设16种不同的岩石与材质一一对应,然后从下到上一层层糊上去,糊的时候加点Noise,在MaxDepth=15也就是整个65536^3的情况下占用内存大约在20m左右,估计多加几种材质还会翻翻,但是在这个数量级下我觉得已经可以了
后续可以改进的方向
- uint32存储引用计数有点浪费,以后在最后这个uint32里可能还会加上一些其他数据,比如当前节点的深度或者顺带记录一下该节点是中间节点还是底层节点或者多线程锁什么的
- 可以加多生产者单消费者的多线程优化,异步操作
- 像OpenVDB那样的访存cache,这样就可以一步到底,省下多次随机访问的性能消耗
- 亦或者可以把InternalNode加宽,类似B树,进一步降低向下访问的消耗
一些废话:
类似Minecraft?
是的,我想构建一种可以实现更大规模的方法
Minecraft体素也挺多的啊,它是怎么做的?
一个chunk就是一个单纯的int[16][16][256]的数组,然后不同chunk走hash
最后,感谢阅读
参考:
- https://graphics.tudelft.nl/Publications-new/2020/CBE20/ModifyingCompressedVoxels-main.pdf
- Milo Yip:以体素建构三维游戏世界
- 探寻可能:体素引擎,来自元宇宙的基本问题2·实现路径
- https://www.cse.chalmers.se/~uffe/dolonius2017i3d.pdf
- https://github.com/aappleby/smhasher/wiki/MurmurHash3
- https://github.com/Phyronnaz/HashDAG
- https://github.com/DavidWilliams81/cubiquity
原文发表于知乎。